Hay un número que te ponen enfrente en cada feria este año. Millones de componentes analizados. Miles de plantas. Décadas de historial de fallas. El mensaje implícito es siempre el mismo: nuestra inteligencia artificial sabe más que las demás, porque la alimentaron con más datos.
Es un número impresionante. También es el número equivocado para comparar — y no lo digo por mercadotecnia, sino por cómo funcionan en realidad estos sistemas.
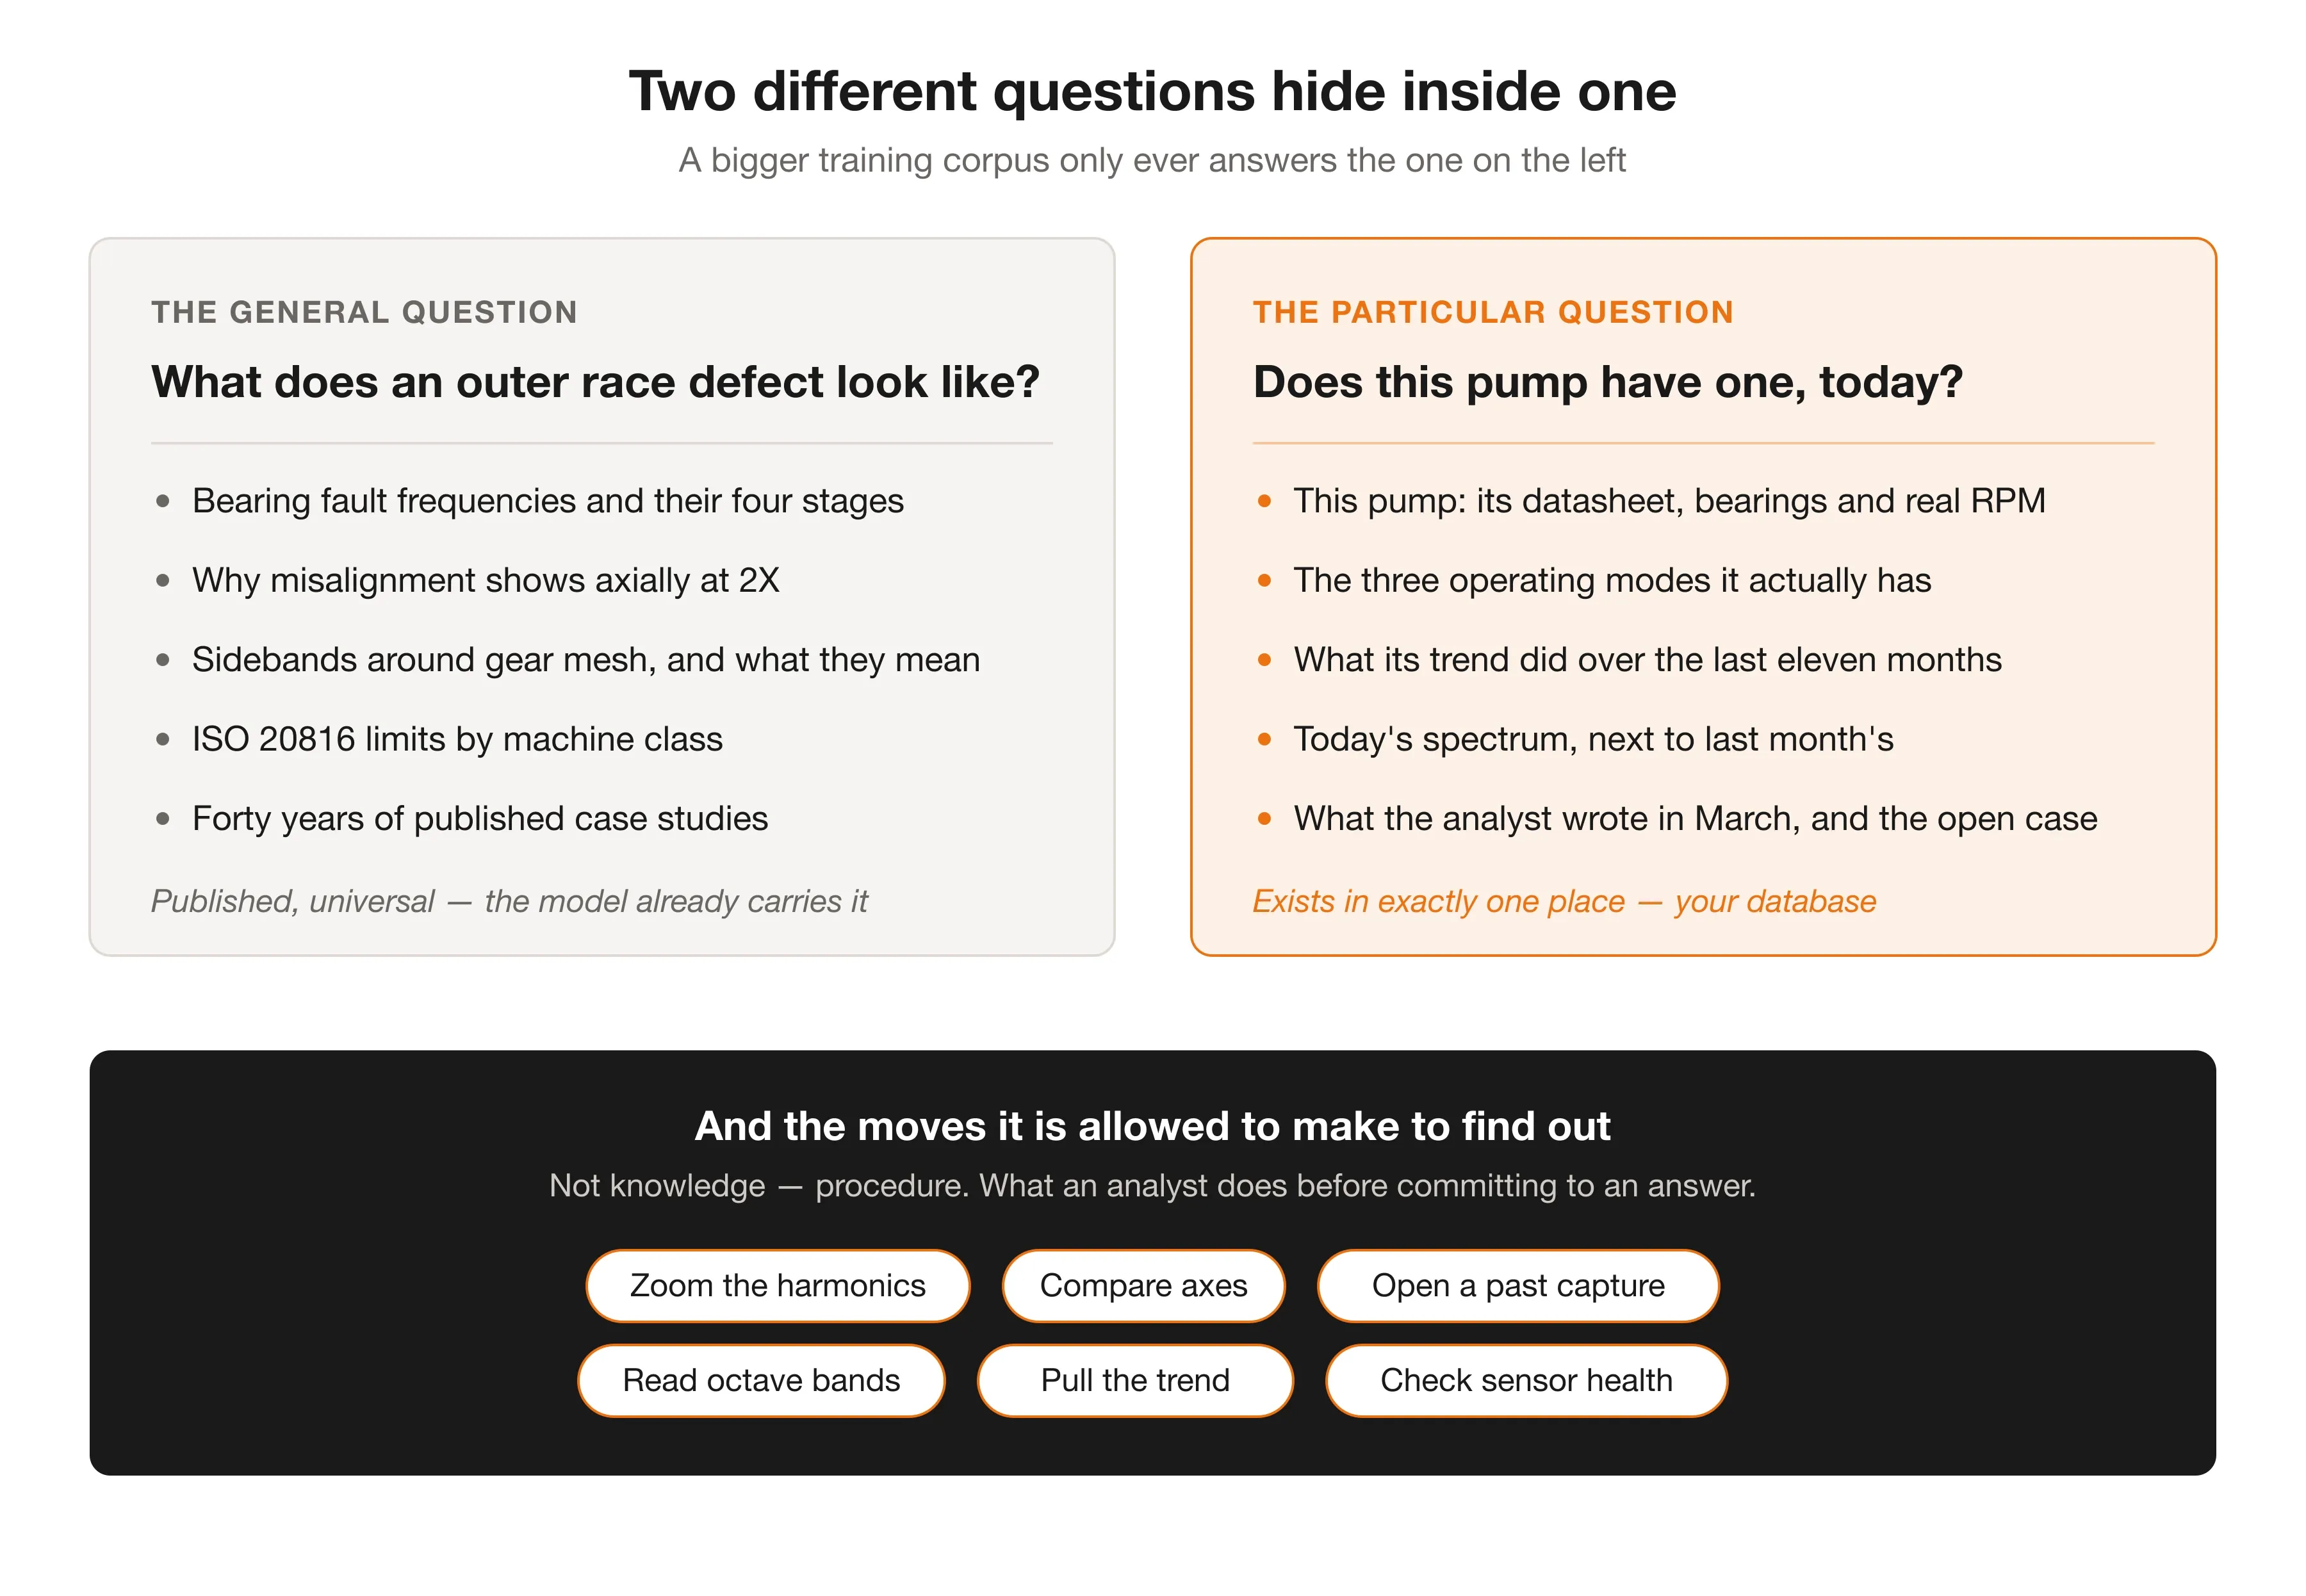
Respuesta corta. El conocimiento general del análisis de vibraciones —frecuencias de falla, normas, patrones de falla, las cuatro etapas de un defecto de rodamiento— está publicado, y cualquier modelo de lenguaje competente ya lo tiene incorporado. Ningún proveedor es dueño de ese conocimiento ni puede vendértelo. Lo que decide si un diagnóstico es correcto es cuánto sabe el sistema de tu máquina —su ficha técnica, sus rodamientos, su velocidad real de giro, sus modos de operación, su tendencia, su espectro, su forma de onda, las notas del analista— y que lo tenga todo enfrente al mismo tiempo, algo que ninguna persona puede hacer: nosotros leemos una pantalla a la vez. Y después, si se le permite ir a comprobar aquello de lo que no está seguro. Pídele a cualquier proveedor que te muestre las dos cosas. El tamaño de un corpus de entrenamiento es lo más fácil de afirmar para él y lo más difícil de verificar para ti.
Por qué un conjunto de entrenamiento más grande no da un mejor diagnóstico
Piensa en lo que ese número te está vendiendo en realidad: conocimiento general de vibraciones. Cómo se ve un defecto de rodamiento en un espectro de envolvente. Por qué la desalineación aparece axialmente en 2X. Cómo las bandas laterales alrededor de la frecuencia de engrane revelan un engrane excéntrico. Qué dice la ISO 20816 de una máquina de 200 kW sobre una cimentación rígida.
Nada de eso escasea ya. Está en los libros de texto, en las normas, en las ponencias de congresos y en cuarenta años de casos de estudio publicados, y cualquier modelo de lenguaje serio ya lo leyó completo. No tienes que comprárselo a nadie.
Lo que sí es escaso es algo que ninguna base de datos de fallas ajenas puede contener: tu máquina.
El contexto es el noventa por ciento de la respuesta
Por eso las herramientas importan tanto. No son un segundo ingrediente junto al contexto — son la manera en que el sistema sale a buscar más contexto cuando el que recibió no alcanza.
Un analista humano no diagnostica mirando una sola pantalla. Hace zoom en la zona alrededor de 1X para ver si de verdad hay bandas laterales ahí. Cambia esa misma medición a envolvente. Abre la forma de onda para revisar si los impactos son periódicos. Compara el eje horizontal con el vertical. Abre la captura de hace tres meses y la pone junto a la de hoy. Revisa que el sensor esté sano antes de creer nada de lo que dice.
Nada de eso es conocimiento. Es procedimiento — y un asistente que no puede hacerlo queda reducido a comentar la captura de pantalla que le entregaron.
En EI-Analytic™ el asistente se llama Erby, y dispone de esos mismos pasos en forma de herramientas. Puede:
- pedir la tendencia de cualquier periodo
- leer las bandas de octava
- abrir una captura específica
- hacer zoom en un rango de frecuencia
- comparar ejes, y comparar momentos en el tiempo
- consultar la ficha técnica del activo
- revisar la salud del sensor
- consultar la vista general de la planta
Cuando no está seguro, va a comprobarlo, exactamente como lo haría una persona — y cada paso que da queda visible para ti dentro de la respuesta.
Las capturas de abajo corresponden a una consulta real sobre una bomba real. Nada está preparado de antemano: a Erby se le pidió un diagnóstico, y esto es lo que hizo antes de darlo.
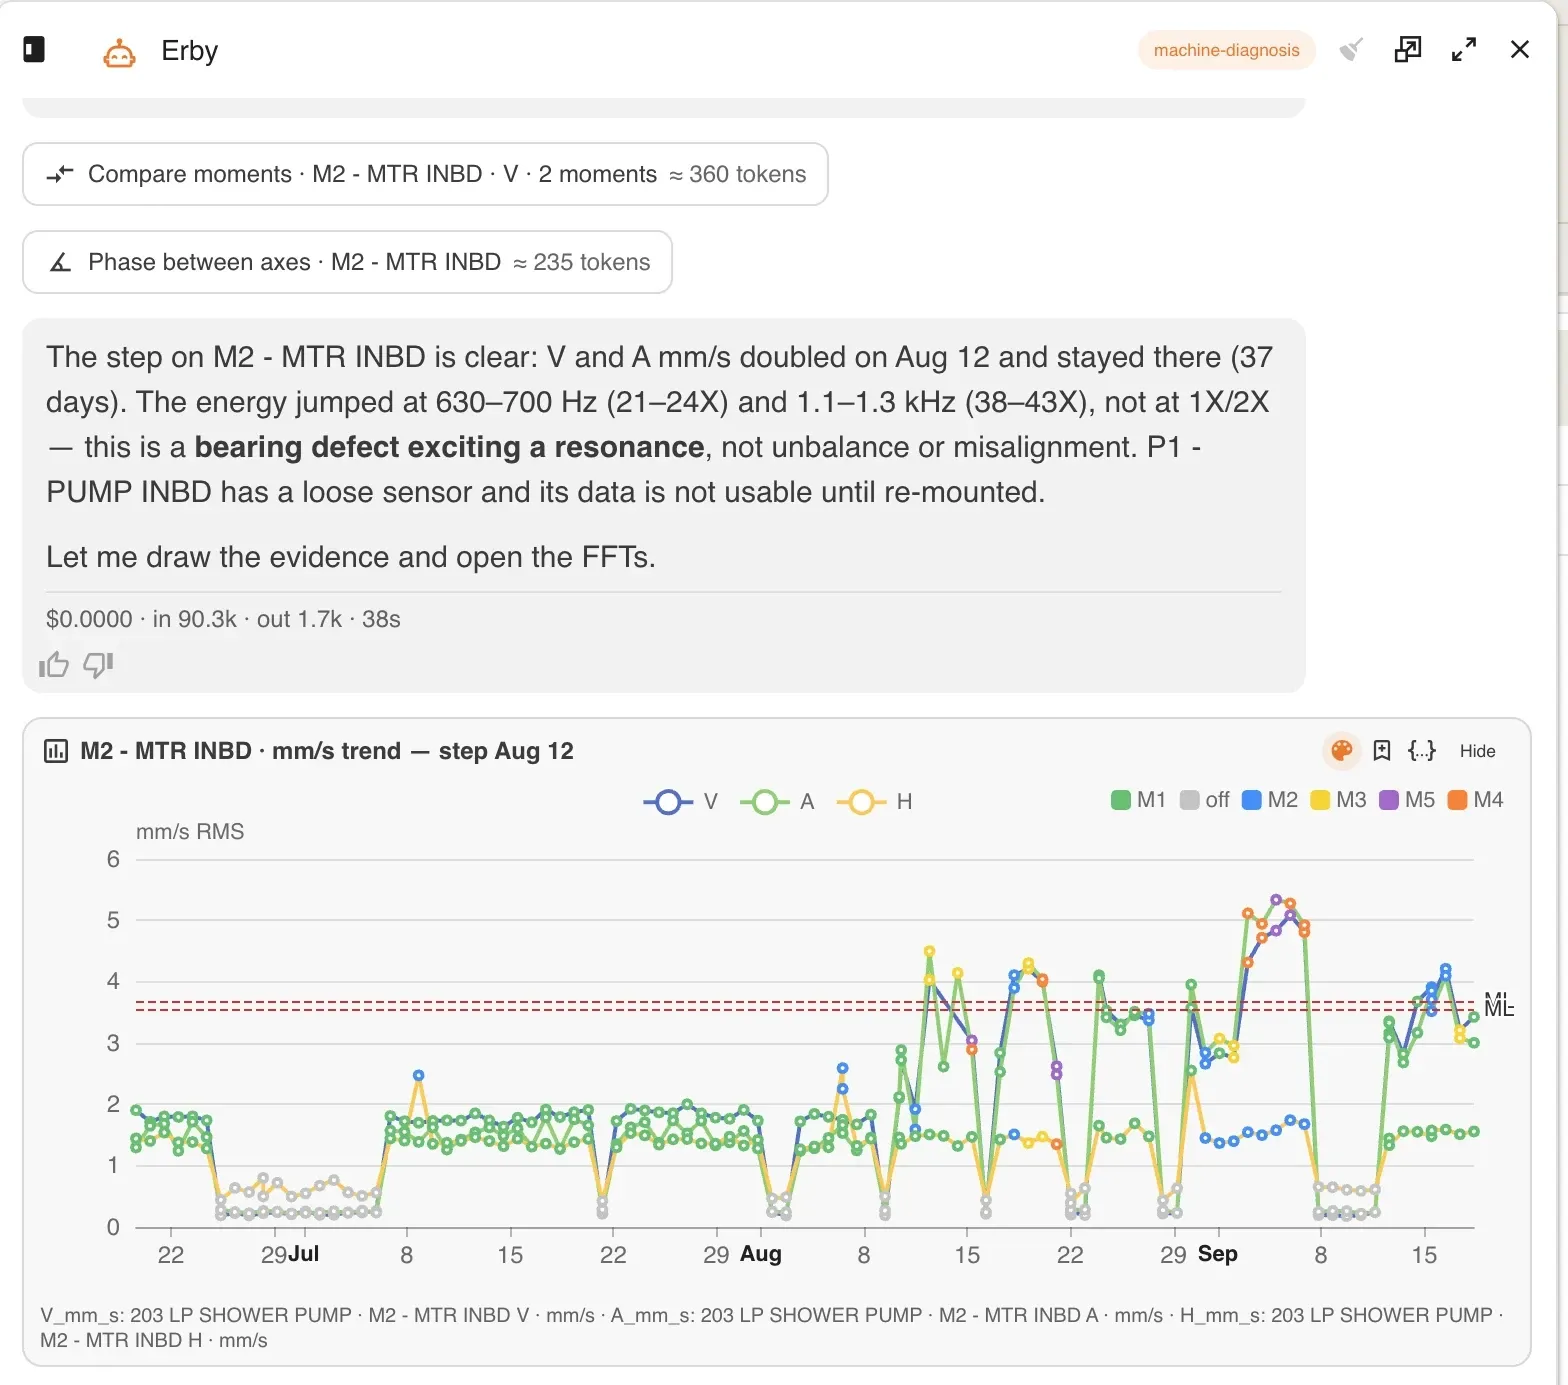
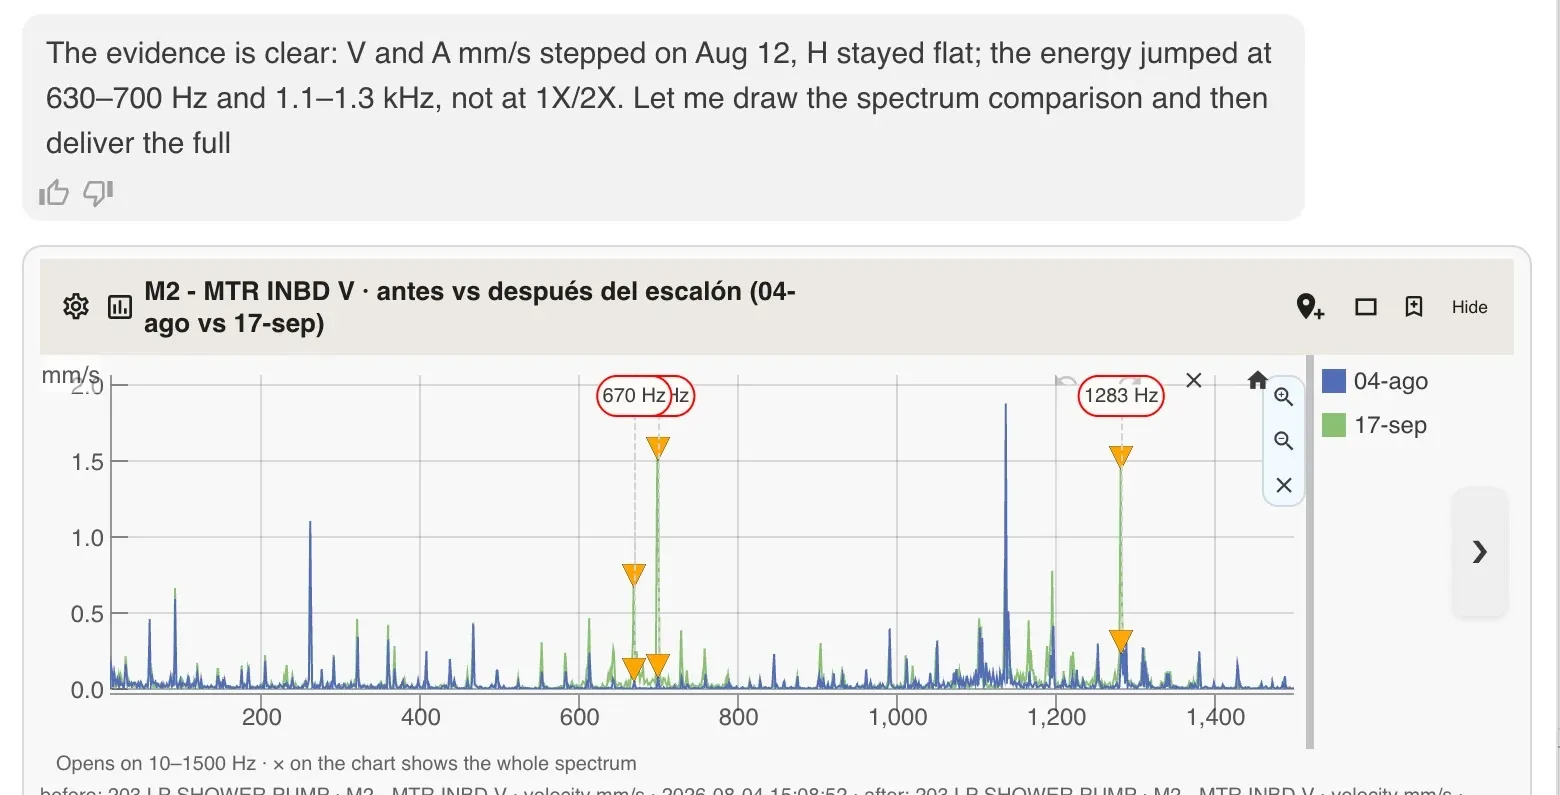
Fíjate de qué está hecha la conclusión. No vibración alta en el motor, sino esto: la energía subió entre 630 y 700 Hz y entre 1.1 y 1.3 kHz, y no en 1X ni en 2X. Es decir, un defecto de rodamiento que excita una resonancia — no un desequilibrio ni una desalineación.
Esa afirmación se puede refutar. Ve al espectro y revisa los números. Que es exactamente lo que hace a continuación, sin que nadie se lo pida.
Así que la comparación que importa no es quién tiene el conjunto de entrenamiento más grande. Es a cuánta de la situación real tiene acceso el sistema, y cuántos de los pasos de un analista puede dar de verdad.
Cómo construye EI-Analytic™ la respuesta: tres capas
Vale la pena dejar claro qué hace cada capa — porque en nuestro software la inteligencia artificial no es la que emite el diagnóstico.
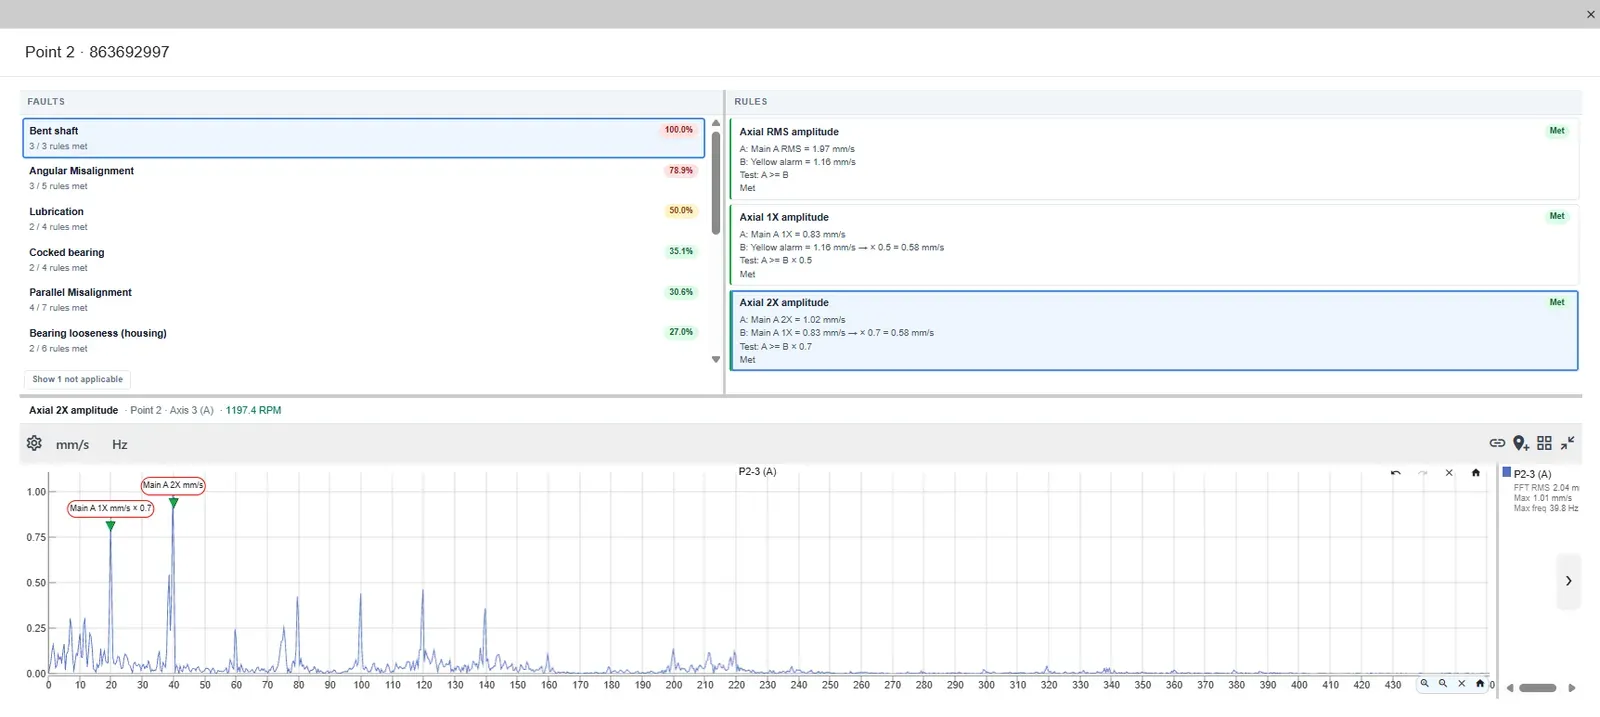
El motor de reglas nombra la falla. Trece tipos de falla, cada uno un conjunto de condiciones con su aritmética a la vista: qué amplitud, comparada con cuál, con qué factor, cumplida o no. Funciona desde la primera medición, sin historial y sin entrenamiento. Y puedes editar cada regla cuando se equivoque con tu ventilador de veinte años. Esto es lo que produce el diagnóstico que ves en el panel.
El aprendizaje automático aprende tu máquina — no la de otro. El clustering agrupa las mediciones de cada punto en los modos de operación que esa máquina realmente tiene, sin que nadie etiquete nada, y avisa cuando aparece un modo que nunca se había visto. Los límites de alarma se aprenden de un periodo sano que tú seleccionas, en ese punto específico. Ambos se entrenan con tus datos, sobre tu equipo — el único entrenamiento que se traslada a tus decisiones.
Erby lee el panorama completo y lo explica. Antes de responder, el software arma un paquete de contexto y te lo muestra primero: qué capas entran, qué tan grande es cada una, y una opción para anonimizar los nombres de empresa y área antes de que se envíe nada. Luego trabaja con las herramientas de arriba y devuelve un reporte con su evidencia adjunta —amplitudes por eje, frecuencias, relaciones respecto a 1X, frecuencias de falla de rodamiento obtenidas de la envolvente— de modo que cada afirmación se pueda rastrear hasta un número medido.
Y la última regla es la que no cambiaríamos por más precisión que nos ofrecieran: el asistente no actúa por su cuenta. Puede preparar un caso, una nota, una ruta o un reporte, pero la ventana se abre ya rellenada y una persona es quien presiona guardar. Tus datos se quedan en tu plataforma. Cada respuesta muestra lo que costó.
La memoria que importa no es la del modelo. Es la tuya.
Un modelo de lenguaje llega con una memoria genérica: todo el mundo y todas las cosas, promediados. Es un buen punto de partida y un mal punto de llegada. Así que dejamos ir buena parte de esa memoria y la reemplazamos por algo que vale muchísimo más: la memoria que el sistema construye a partir del analista que lo usa.
Cómo te gusta configurar las alarmas. Qué máquinas ya decidiste ignorar, y la razón que diste. Que el compresor del área 4 siempre parece alarmante en el arranque y nunca lo está. La forma en que redactas un caso antes de entregarlo a producción. El punto en el que dejas de observar y tomas el teléfono.
Erby guarda todo eso, de forma visible y reversible, y lo trae a la siguiente pregunta. No está aprendiendo vibraciones de ti. Ya sabe vibraciones. Te está aprendiendo a ti.
La pregunta que de verdad separa una IA de vibraciones de otra
La industria está a punto de pasarse un año discutiendo quién tiene el corpus más grande. Es una discusión cómoda para los proveedores, porque se puede afirmar sin que nadie pueda comprobarlo.
La pregunta útil es más simple, y mucho más difícil de falsear. Una IA de vibraciones vale exactamente lo que sabe de la máquina que tiene enfrente, y lo que se le permite hacer para averiguar más. El conocimiento general ya viene gratis con el modelo. El historial de tu máquina, sus modos, su línea base y sus casos abiertos no — y son toda la diferencia entre una respuesta sobre bombas y una respuesta sobre esta bomba.
La nuestra la construimos sobre esa premisa. Deberías hacer que cada proveedor, nosotros incluidos, te muestre exactamente qué está viendo su IA.
Preguntas frecuentes sobre la IA en el análisis de vibraciones
¿Un conjunto de entrenamiento más grande hace más preciso el diagnóstico de vibraciones?
No más allá de cierto punto. El conocimiento general que supuestamente aporta un corpus grande —frecuencias de falla, normas, patrones de falla, límites ISO— ya está publicado, y cualquier modelo de lenguaje competente lo ha leído. Ejemplos adicionales de fallas de otras plantas no le dicen nada al sistema sobre la velocidad, el montaje, los modos de operación ni el historial de la máquina que de verdad estás mirando. Esa información existe únicamente en tu propia base de datos.
¿Qué necesita saber una IA para diagnosticar una máquina específica?
Su ficha técnica y los números de parte de sus rodamientos, su velocidad real de giro, los modos de operación que realmente tiene, su tendencia a lo largo del tiempo, el espectro y la forma de onda de la medición en cuestión, cómo se compara un eje con otro, y qué han escrito los analistas sobre ella antes. En EI-Analytic™ ese paquete de contexto se arma desde tu propia base de datos y se te muestra antes de que se envíe nada, con la opción de anonimizar primero los nombres de empresa y área.
¿Puede un asistente de IA comprobar algo de lo que no está seguro?
Puede, si se le han dado herramientas para hacerlo. Un asistente que solo ve una captura de pantalla no puede hacer otra cosa que comentar esa captura. Erby puede pedir la tendencia de cualquier periodo, abrir una captura específica, hacer zoom en un rango de frecuencia, cambiar a envolvente, comparar ejes y comparar dos momentos en el tiempo — los mismos pasos que da un analista humano, con cada uno visible en la respuesta.
Entonces, ¿una base de datos de fallas es inútil para el monitoreo de condición?
No. Es realmente útil para un conjunto específico de tareas: límites de alarma iniciales razonables por tipo de componente, marcos de criticidad, los modos de falla que conviene considerar para una clase de activo, y cuánto suele tardar en progresar un defecto determinado. En una máquina nueva sin historial propio, la estadística de máquinas parecidas es la mejor primera aproximación disponible. Lo que una población no puede hacer es decirte qué está haciendo hoy una máquina individual.
¿El historial de una máquina puede predecir lo que hará una máquina idéntica?
No de forma confiable. Dos bombas idénticas —mismo modelo, mismo año, mismo servicio— montadas a cuarenta metros una de otra mostrarán líneas base distintas, porque la rigidez de la cimentación, los esfuerzos de la tubería y las resonancias locales no son los mismos. Los datos poblacionales te dicen qué esperar de esa clase de máquina; solo la línea base de esa máquina te dice si algo cambió.
Para seguir leyendo