Il y a un chiffre qu’on vous met sous les yeux à chaque salon cette année. Des millions de composants analysés. Des milliers d’usines. Des décennies d’historique de défauts. Le sous-entendu est toujours le même : notre intelligence artificielle en sait plus que les autres, parce qu’on l’a nourrie avec plus de données.
C’est un chiffre impressionnant. C’est aussi le mauvais chiffre à comparer — et pas pour une raison marketing, mais à cause de la façon dont ces systèmes fonctionnent réellement.
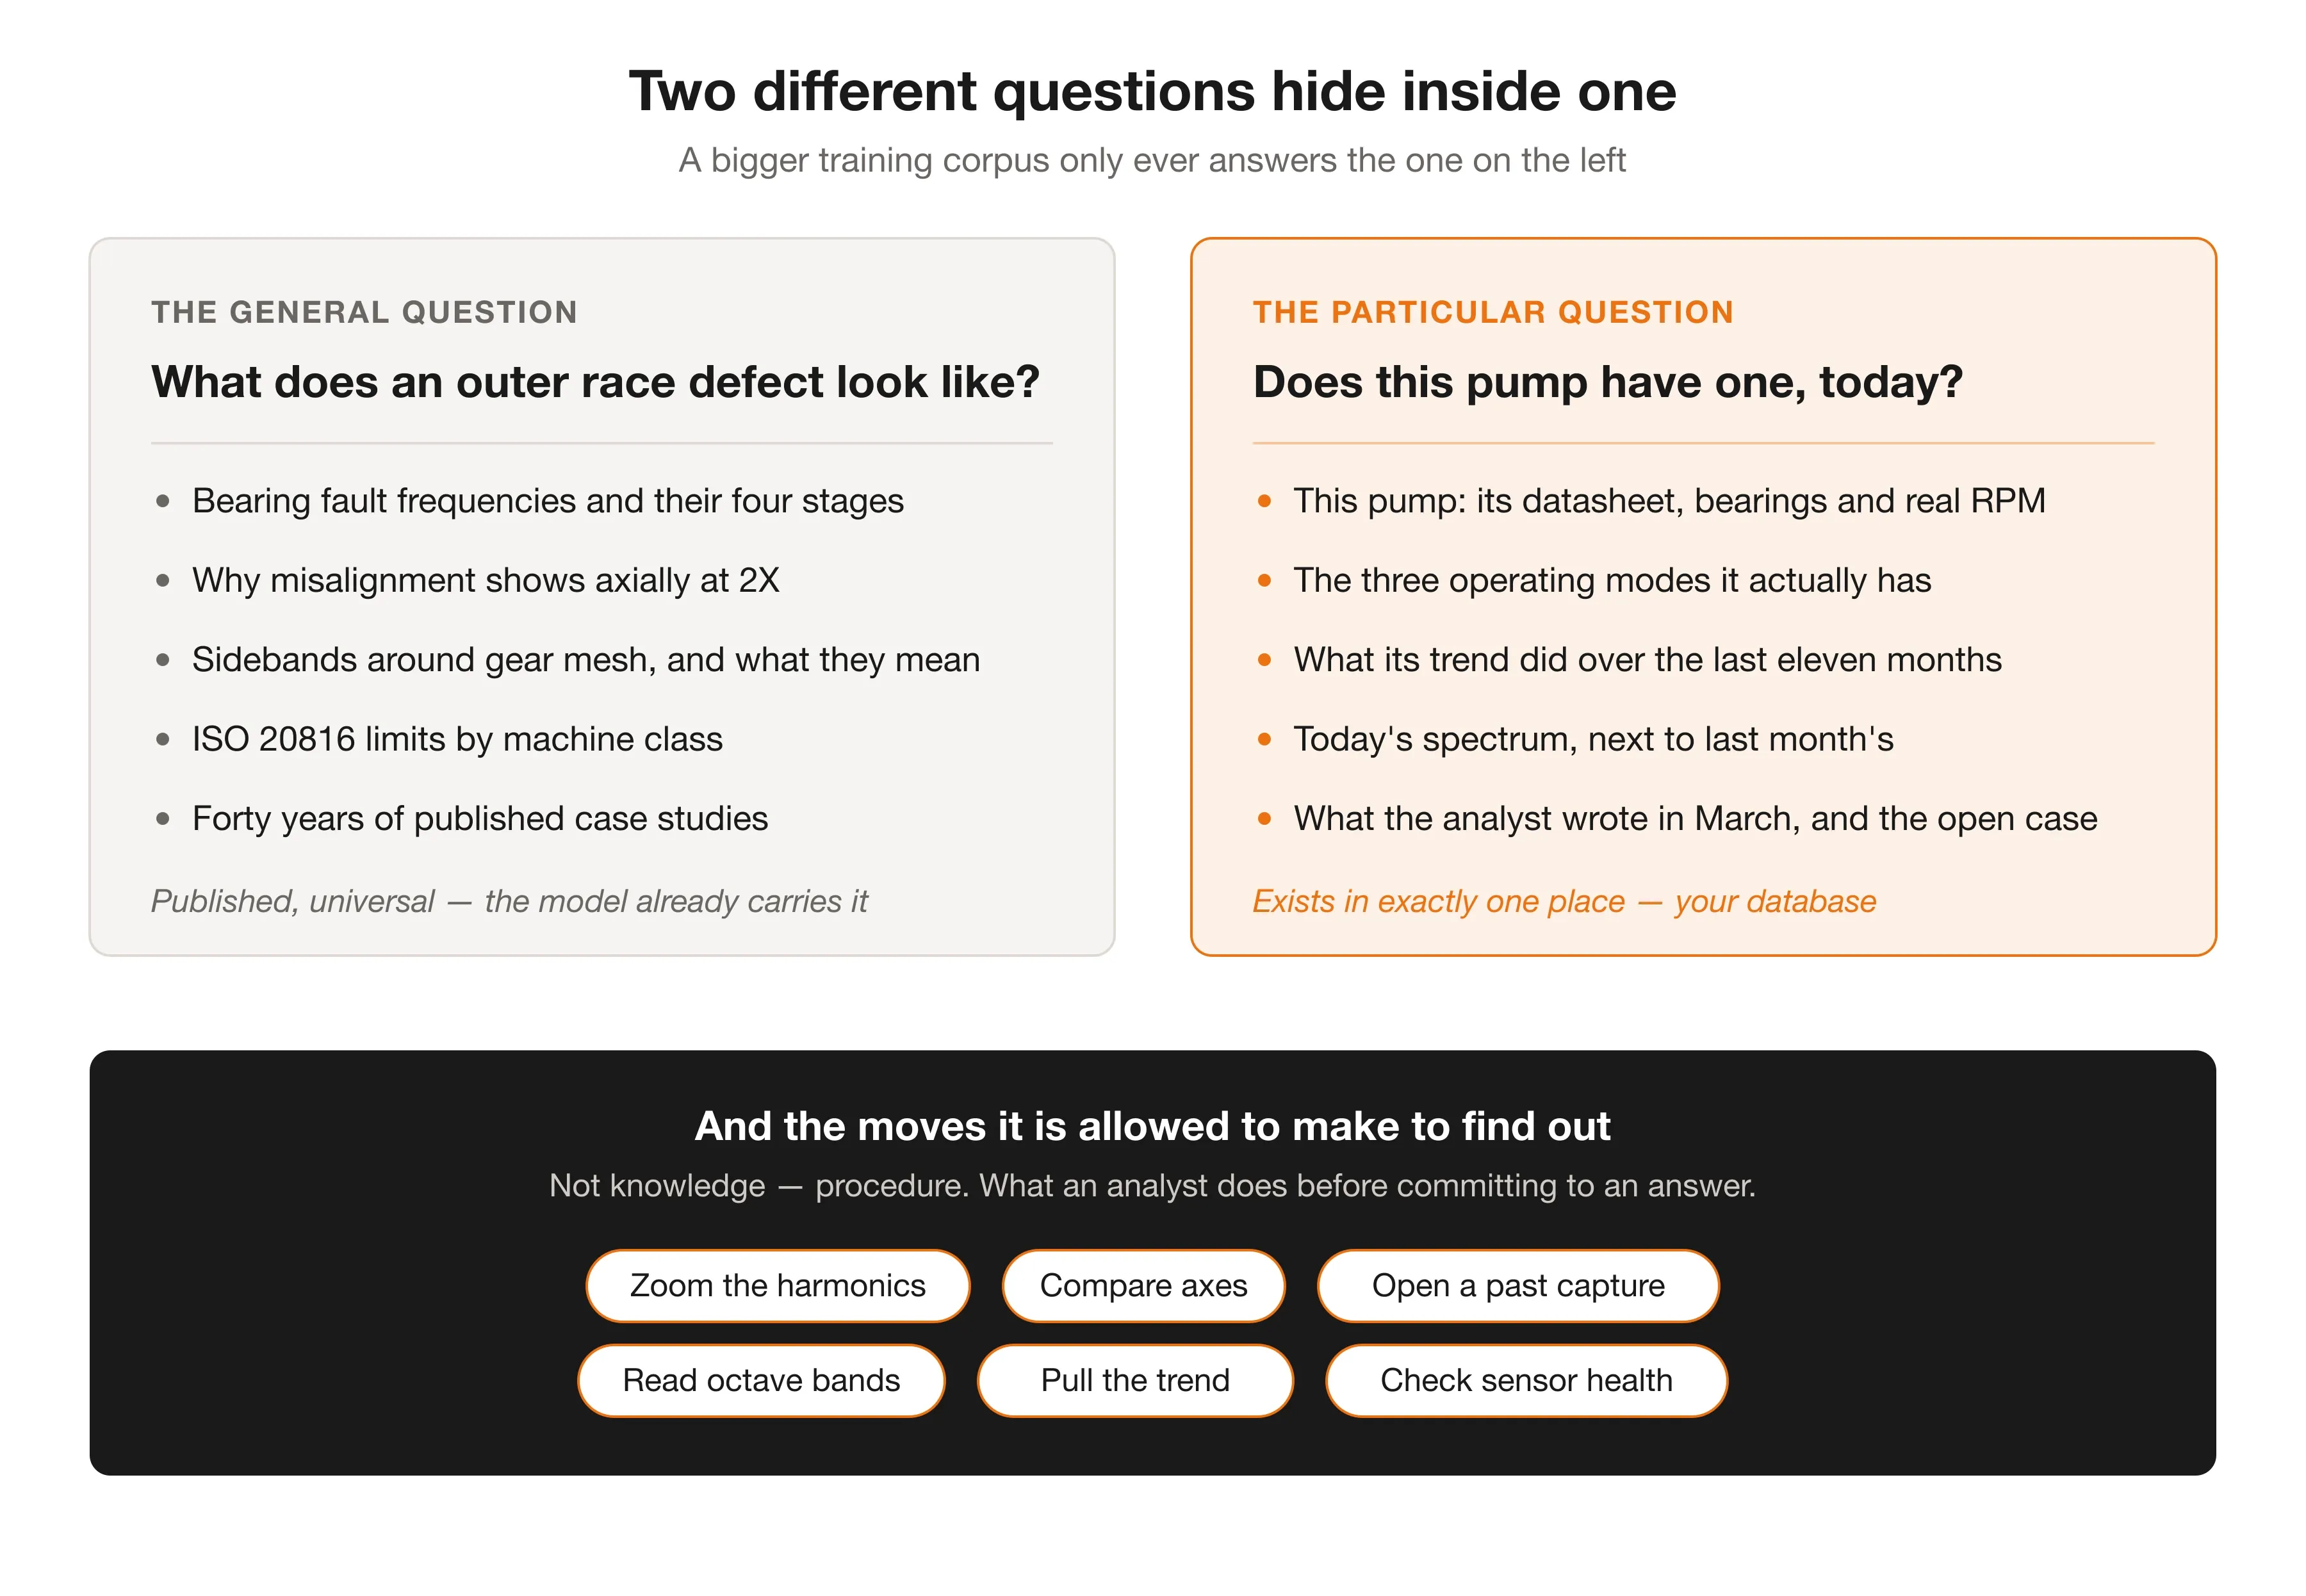
Réponse courte. Le savoir général de l’analyse vibratoire — fréquences de défaut, normes, signatures de défaillance, les quatre stades d’un défaut de roulement — est publié, et tout modèle de langage sérieux le possède déjà. Aucun fournisseur n’est propriétaire de ce savoir et aucun ne peut vous le vendre. Ce qui décide si un diagnostic est juste, c’est ce que le système sait de votre machine — sa fiche technique, ses roulements, sa vitesse de rotation réelle, ses modes de fonctionnement, sa tendance, son spectre, sa forme d’onde, les notes de l’analyste — et qu’il ait tout cela devant lui en même temps, ce qu’aucune personne ne peut faire : nous lisons un écran à la fois. Et ensuite, s’il a le droit d’aller vérifier ce dont il n’est pas sûr. Demandez à chaque fournisseur de vous montrer les deux. La taille d’un corpus d’entraînement est ce qu’il y a de plus facile à affirmer pour lui et de plus difficile à vérifier pour vous.
Pourquoi un corpus d’entraînement plus grand ne donne pas un meilleur diagnostic
Réfléchissez à ce que ce chiffre vous vend réellement : du savoir vibratoire général. À quoi ressemble un défaut de roulement dans un spectre d’enveloppe. Pourquoi le désalignement apparaît axialement à 2X. Comment les bandes latérales autour de l’engrènement révèlent un engrenage excentré. Ce que dit l’ISO 20816 d’une machine de 200 kW sur une fondation rigide.
Rien de tout cela n’est rare aujourd’hui. Tout se trouve dans les manuels, les normes, les actes de congrès et quarante ans d’études de cas publiées, et tout modèle de langage sérieux a déjà tout lu. Vous n’avez à l’acheter à personne.
Ce qui est rare, c’est une chose qu’aucune base de données de défaillances d’autrui ne peut contenir : votre machine.
Le contexte, c’est quatre-vingt-dix pour cent de la réponse
C’est pour cela que les outils comptent autant. Ils ne sont pas un second ingrédient posé à côté du contexte — ils sont le moyen par lequel le système va chercher davantage de contexte quand ce qu’on lui a remis ne suffit pas.
Un analyste humain ne diagnostique pas en fixant un seul écran. Il zoome autour de 1X pour voir s’il y a vraiment des bandes latérales. Il bascule la même mesure en enveloppe. Il ouvre la forme d’onde pour vérifier si les chocs sont périodiques. Il compare l’axe horizontal à l’axe vertical. Il ouvre la capture d’il y a trois mois et la met à côté de celle d’aujourd’hui. Il vérifie que le capteur lui-même est sain avant de croire quoi que ce soit de ce qu’il dit.
Rien de tout cela n’est du savoir. C’est de la procédure — et un assistant qui ne peut pas le faire se réduit à commenter la capture d’écran qu’on lui a tendue.
Dans EI-Analytic™, l’assistant s’appelle Erby, et il dispose de ces mêmes gestes sous forme d’outils. Il peut :
- demander la tendance sur n’importe quelle période
- lire les bandes d’octave
- ouvrir une capture précise
- zoomer sur une plage de fréquences
- comparer des axes, et comparer des instants
- récupérer la fiche technique de l’actif
- vérifier la santé du capteur
- lire la vue d’ensemble de l’usine
Quand il n’est pas sûr, il va voir, exactement comme le ferait une personne — et chaque étape qu’il franchit vous reste visible dans la réponse.
Les captures ci-dessous montrent un échange réel sur une pompe réelle. Rien n’est mis en scène : on a demandé un diagnostic à Erby, et voici ce qu’il a fait avant de le donner.
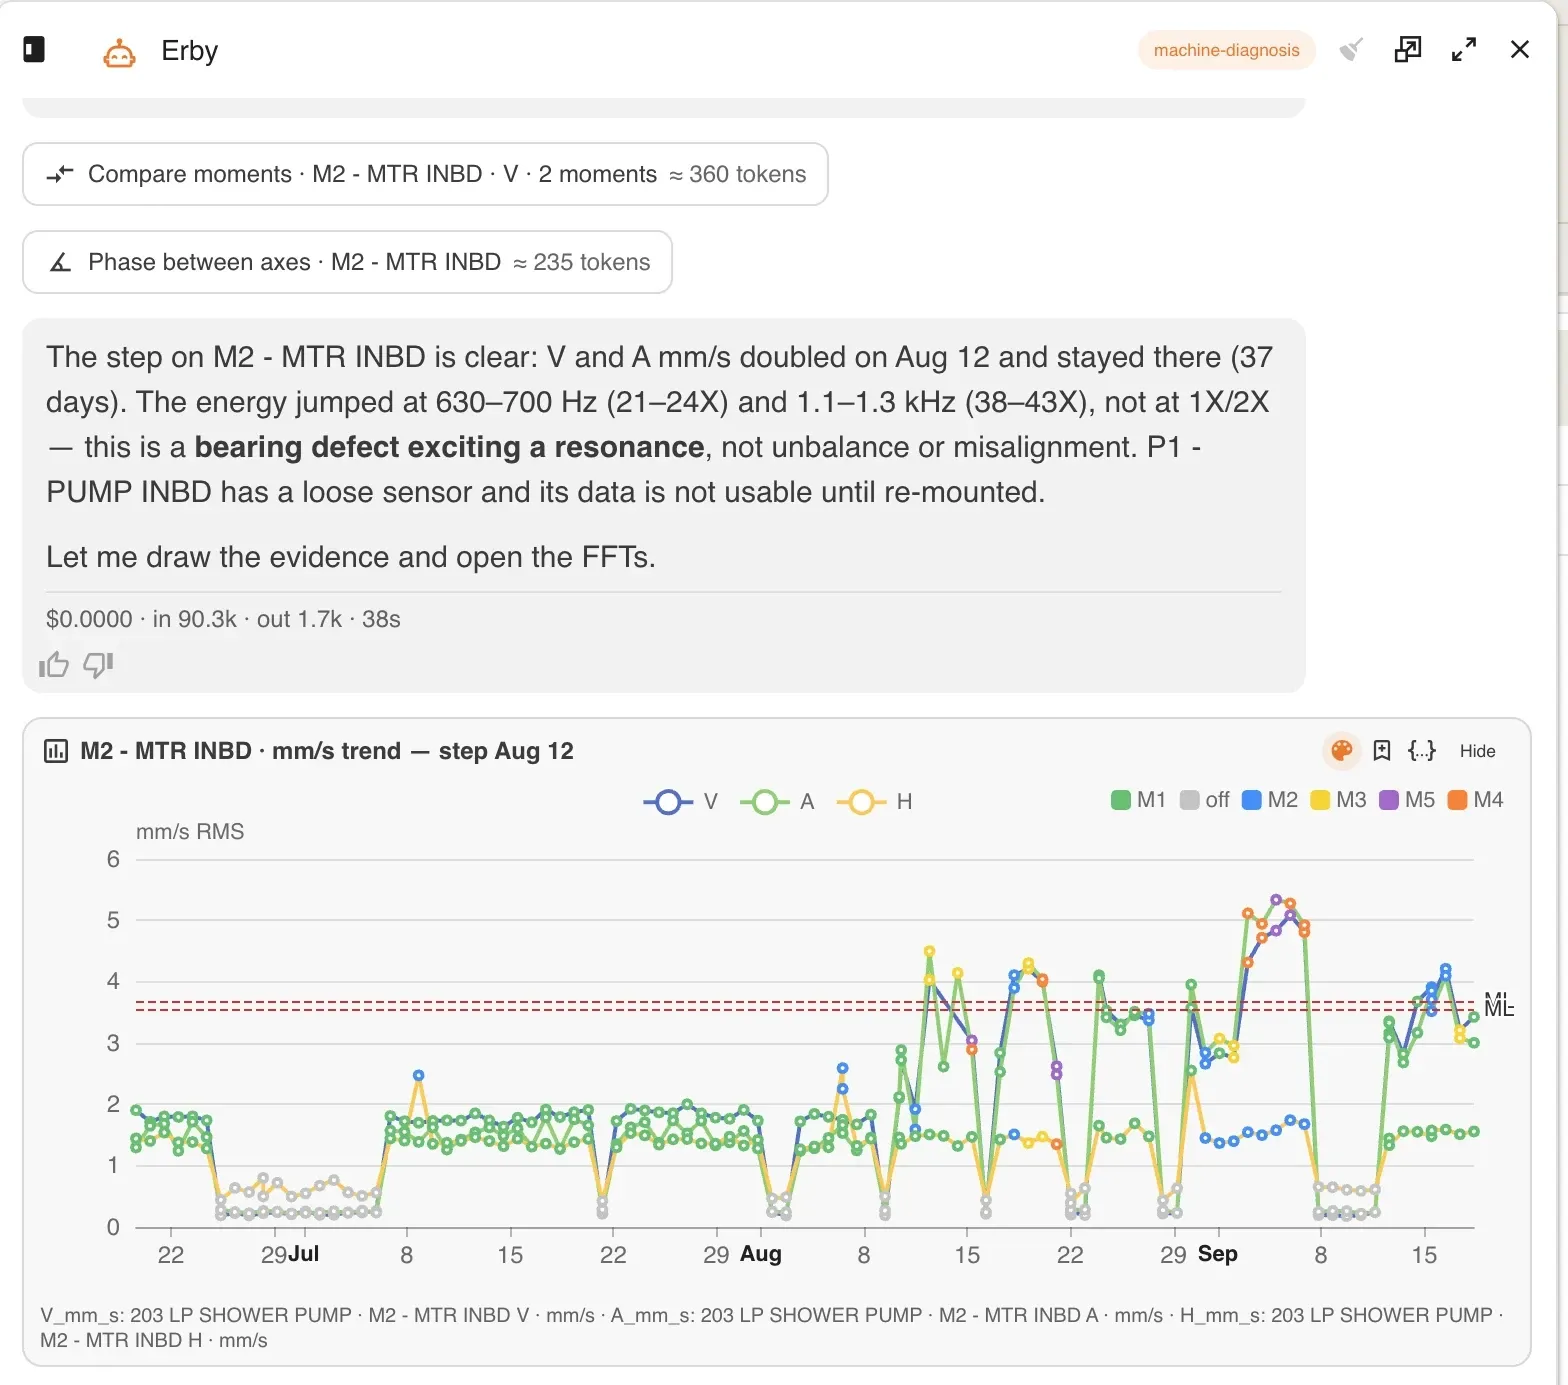
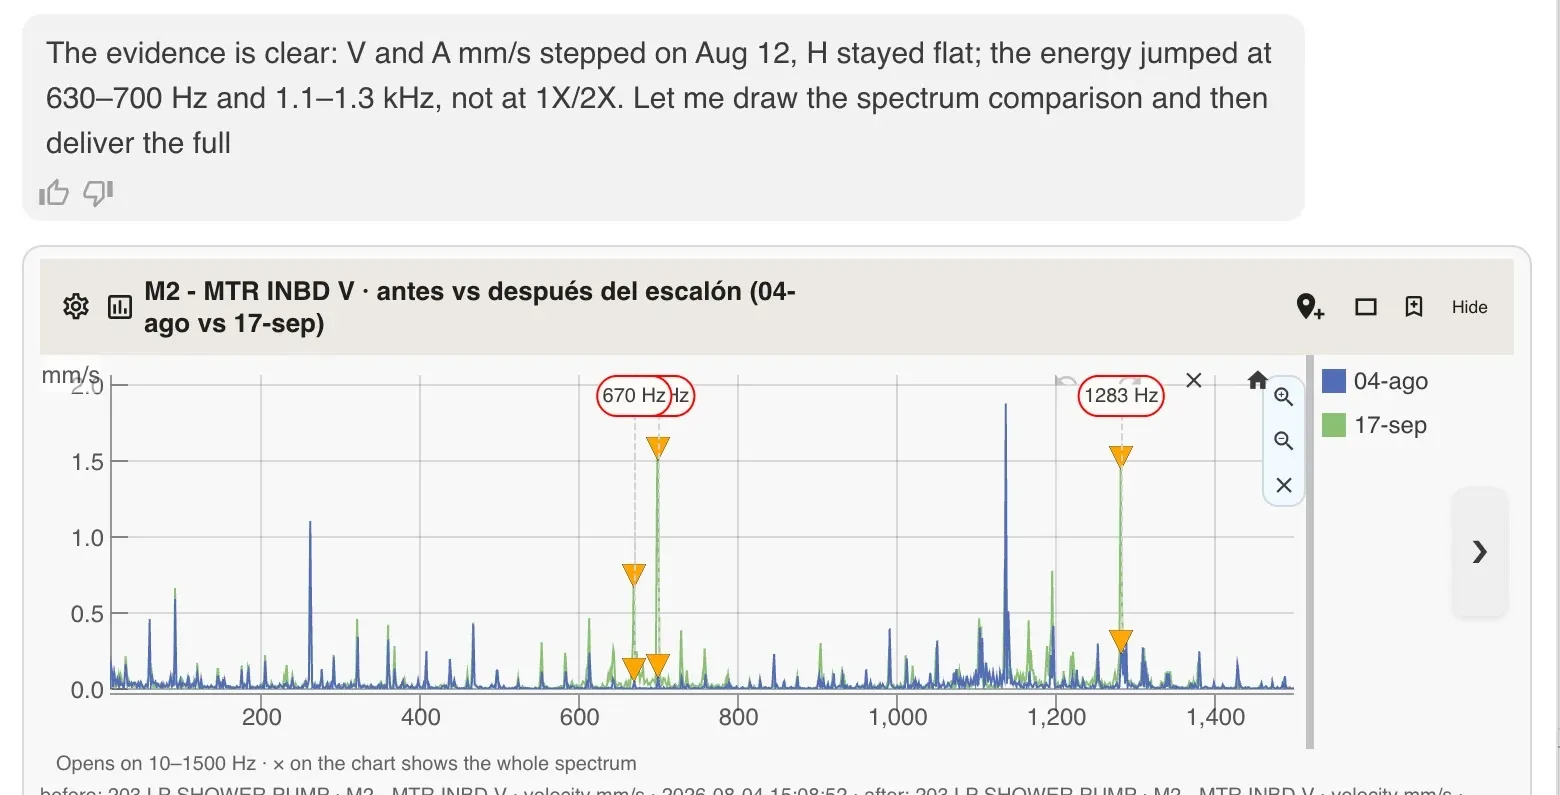
Regardez de quoi la conclusion est faite. Pas vibration élevée sur le moteur, mais ceci : l’énergie a augmenté entre 630 et 700 Hz et entre 1,1 et 1,3 kHz, et pas à 1X ni à 2X. Ce qui signifie un défaut de roulement excitant une résonance — ni balourd, ni désalignement.
Cette affirmation peut être réfutée. Allez au spectre et vérifiez les chiffres. C’est exactement ce qu’il fait ensuite, sans qu’on le lui demande.
La comparaison qui compte n’est donc pas de qui le corpus d’entraînement est le plus gros. C’est quelle part de la situation réelle le système peut atteindre, et combien de gestes d’analyste il peut réellement accomplir.
Comment EI-Analytic™ construit la réponse : trois couches
Il vaut la peine d’être explicite sur ce que fait chaque couche — parce que dans notre logiciel ce n’est pas l’intelligence artificielle qui émet le diagnostic.
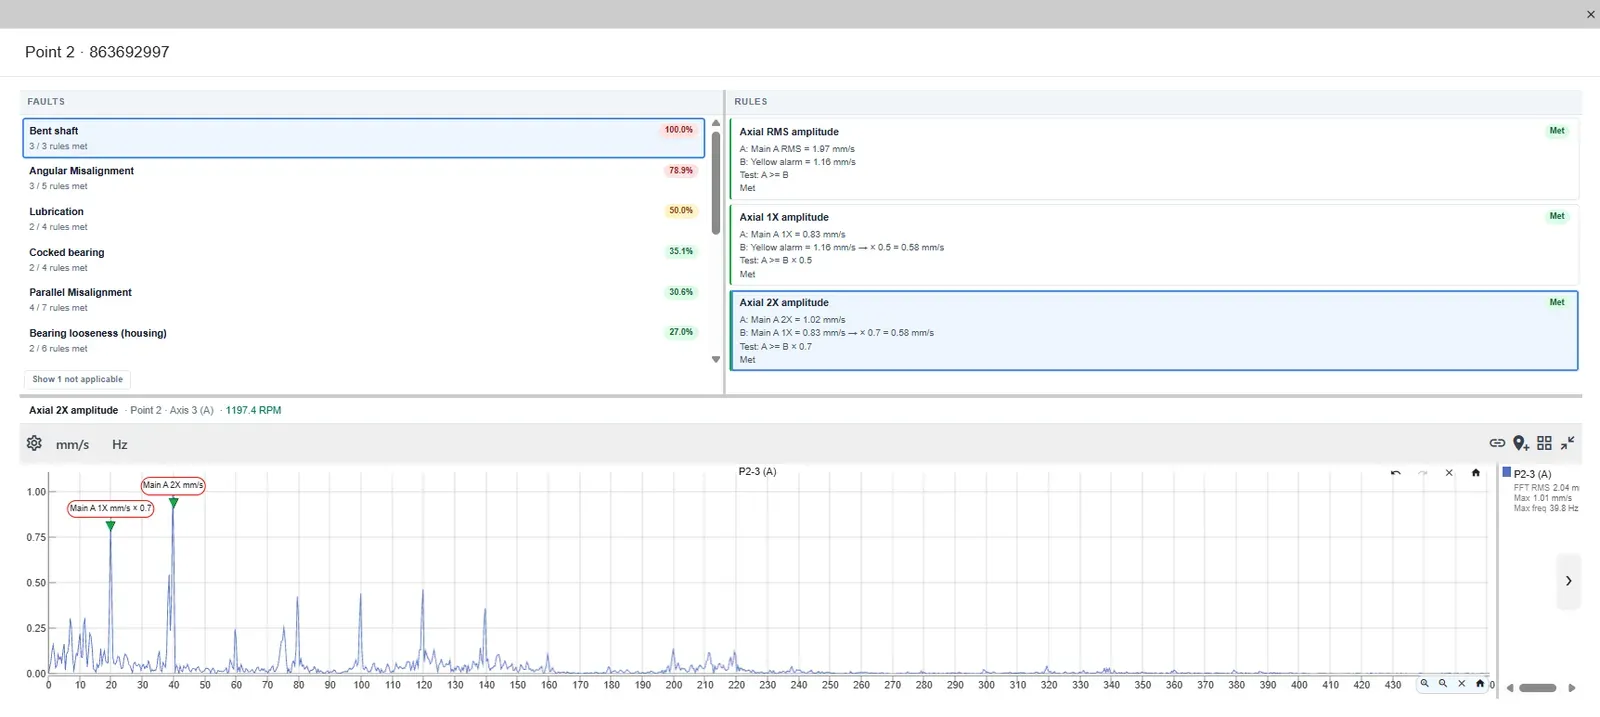
Le moteur de règles nomme le défaut. Treize types de défauts, chacun étant un ensemble de conditions dont le calcul est visible : quelle amplitude, comparée à laquelle, avec quel facteur, condition remplie ou non. Il fonctionne dès la toute première mesure, sans historique et sans entraînement. Et vous pouvez modifier chaque règle quand elle se trompe sur votre ventilateur de vingt ans. C’est ce qui produit le diagnostic que vous voyez sur le tableau de bord.
L’apprentissage automatique apprend votre machine — pas celle d’un autre. Le clustering regroupe les mesures de chaque point dans les modes de fonctionnement que cette machine a réellement, sans que personne n’étiquette quoi que ce soit, et signale l’apparition d’un mode jamais vu. Les limites d’alarme sont apprises sur une période saine que vous sélectionnez, sur ce point précis. Les deux sont entraînés sur vos données, à propos de votre équipement — le seul entraînement qui se transfère à vos décisions.
Erby lit l’ensemble du tableau et l’explique. Avant de répondre, le logiciel assemble un paquet de contexte et vous le montre d’abord : quelles couches y entrent, quelle est la taille de chacune, et une option pour anonymiser les noms d’entreprise et de zone avant tout envoi. Ensuite il travaille avec les outils ci-dessus et renvoie un rapport avec ses preuves jointes — amplitudes par axe, fréquences, rapports à 1X, fréquences de défaut de roulement issues de l’enveloppe — de sorte que chaque affirmation remonte à un nombre mesuré.
Et la dernière règle est celle que nous n’échangerions contre aucune quantité de précision : l’assistant n’agit pas de lui-même. Il peut préparer un cas, une note, une ronde ou un rapport, mais la fenêtre s’ouvre déjà remplie et c’est une personne qui clique sur enregistrer. Vos données restent dans votre plateforme. Chaque réponse montre ce qu’elle a coûté.
La mémoire qui compte n’est pas celle du modèle. C’est la vôtre.
Un modèle de langage arrive avec une mémoire générique : tout le monde et tout, moyenné. C’est un bon point de départ et un mauvais point d’arrivée. Nous laissons donc de côté une bonne partie de cette mémoire et la remplaçons par quelque chose qui vaut bien davantage : la mémoire que le système construit à partir de l’analyste qui l’utilise.
La façon dont vous aimez régler vos alarmes. Quelles machines vous avez déjà décidé d’ignorer, et la raison que vous avez donnée. Que le compresseur de la zone 4 paraît toujours alarmant au démarrage et ne l’est jamais. La façon dont vous rédigez un cas avant de le transmettre à la production. Le moment où vous cessez d’observer et décrochez le téléphone.
Erby garde tout cela, de façon visible et réversible, et l’apporte à la question suivante. Il n’apprend pas les vibrations auprès de vous. Il connaît déjà les vibrations. C’est vous qu’il apprend.
La question qui sépare vraiment une IA de vibrations d’une autre
L’industrie s’apprête à passer une année à débattre de qui a le plus gros corpus. C’est un débat confortable pour les fournisseurs, parce qu’on peut l’affirmer sans que personne puisse le vérifier.
La question utile est plus simple, et bien plus difficile à truquer. Une IA de vibrations ne vaut que ce qu’elle sait de la machine devant elle, et ce qu’on lui permet de faire pour en savoir plus. L’expertise générale est désormais fournie avec le modèle. L’historique de votre machine, ses modes, son niveau de référence et ses cas ouverts, non — et c’est là toute la différence entre une réponse sur les pompes et une réponse sur cette pompe.
C’est sur cette hypothèse que nous avons construit la nôtre. Vous devriez exiger de chaque fournisseur, nous compris, qu’il vous montre exactement ce que son IA regarde.
Questions fréquentes sur l’IA en analyse vibratoire
Un corpus d’entraînement plus grand rend-il le diagnostic vibratoire plus précis ?
Pas au-delà d’un certain point. Le savoir général qu’un grand corpus est censé apporter — fréquences de défaut, normes, signatures de défaillance, limites ISO — est déjà publié, et tout modèle de langage sérieux l’a lu. Des exemples supplémentaires de défaillances d’autres usines ne disent rien au système sur la vitesse, le montage, les modes de fonctionnement ou l’historique de la machine que vous regardez réellement. Cette information n’existe que dans votre propre base de données.
Que doit savoir une IA pour diagnostiquer une machine précise ?
Sa fiche technique et les références de ses roulements, sa vitesse de rotation réelle, les modes de fonctionnement qu’elle a vraiment, sa tendance dans le temps, le spectre et la forme d’onde de la mesure en question, la comparaison d’un axe à l’autre, et ce que les analystes ont écrit à son sujet auparavant. Dans EI-Analytic™, ce paquet de contexte est assemblé depuis votre propre base de données et vous est montré avant tout envoi, avec la possibilité d’anonymiser d’abord les noms d’entreprise et de zone.
Un assistant IA peut-il vérifier ce dont il n’est pas sûr ?
Il le peut, si on lui a donné des outils pour le faire. Un assistant qui ne voit qu’une capture d’écran ne peut rien faire d’autre que commenter cette capture. Erby peut demander une tendance sur n’importe quelle période, ouvrir une capture précise, zoomer sur une plage de fréquences, basculer en enveloppe, comparer des axes et comparer deux instants — les mêmes gestes qu’un analyste humain, chaque étape restant visible dans la réponse.
Une base de données de défaillances est-elle donc inutile en surveillance conditionnelle ?
Non. Elle est réellement utile pour un ensemble de tâches précis : des limites d’alarme initiales raisonnables par type de composant, des cadres de criticité, les modes de défaillance à envisager pour une classe d’actif, et le temps que met généralement un défaut donné à progresser. Sur une machine neuve sans historique propre, les statistiques de machines semblables sont la meilleure première estimation disponible. Ce qu’une population ne peut pas faire, c’est vous dire ce que fait aujourd’hui une machine individuelle.
L’historique d’une machine peut-il prédire ce que fera une machine identique ?
Pas de façon fiable. Deux pompes identiques — même modèle, même année, même service — montées à quarante mètres l’une de l’autre montreront des niveaux de référence différents, parce que la rigidité de la fondation, les contraintes de tuyauterie et les résonances locales ne sont pas les mêmes. Les données de population vous disent ce à quoi vous attendre de cette classe de machines ; seul le niveau de référence propre à cette machine vous dit si quelque chose a changé.
Pour aller plus loin
- Les 5 questions auxquelles votre diagnostic automatisé doit répondre avant que vous lui fassiez confiance
- Votre Système de Diagnostic Vibratoire est-il une Boîte Noire ou une Boîte Blanche ?
- L’IA Responsable dans la Surveillance Conditionnelle
- Logiciel d’analyse vibratoire Digivibe MX® et EI-Analytic™